


Data Center de IA: Redundância Elétrica em Instalações de Computação de Alta Densidade
Data de lançamento: 16/10/2026
Índice
A transição da computação empresarial tradicional para cargas de trabalho de alto desempenho e com uso intensivo de processadores reescreveu fundamentalmente as regras da engenharia de instalações. No passado, os operadores de instalações podiam provisionar confortavelmente de 5 a 10 quilowatts (kW) de energia por rack. Hoje, a implantação de clusters massivos de unidades de processamento gráfico (GPUs) elevou a densidade de racks para 40 kW, 80 kW e até mais de 120 kW. Esse aumento exponencial na densidade de energia transformou a infraestrutura elétrica de uma mera necessidade operacional no ativo estratégico mais crítico que uma empresa de tecnologia pode possuir.
Em ambientes onde algoritmos são treinados por semanas ou meses consecutivos, uma interrupção de energia de apenas alguns milissegundos pode corromper petabytes de progresso. As consequências financeiras de tal inatividade são catastróficas, frequentemente medidas em milhões de dólares em tempo computacional perdido e atrasos nos ciclos de lançamento de produtos no mercado. Consequentemente, projetar uma infraestrutura elétrica resiliente é a principal diretriz para qualquer Centro de Dados de IA. Este guia abrangente explora as sofisticadas topologias de confiabilidade necessárias para manter as cargas de trabalho computacionais de última geração em funcionamento sem interrupções, aprofundando-se no planejamento de capacidade, na tolerância a falhas e na economia do tempo de atividade.
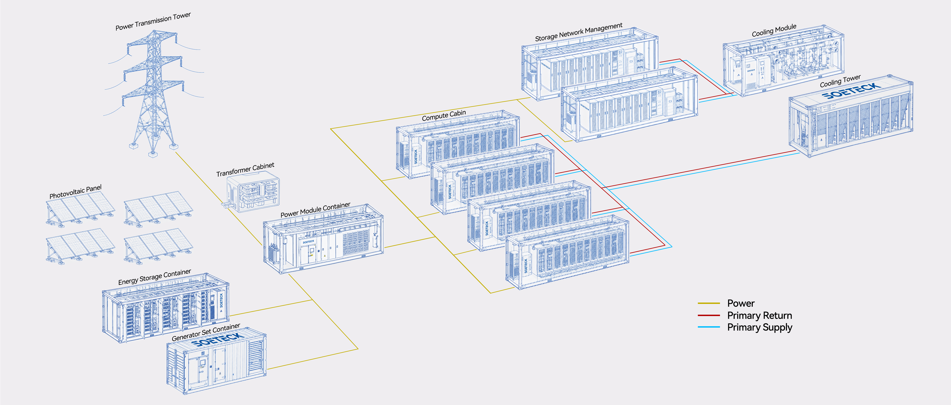
A mudança de paradigma nas demandas de energia elétrica
Para entender a necessidade de topologias de confiabilidade avançadas, é preciso primeiro compreender o comportamento singular das cargas de trabalho de aprendizado de máquina modernas. Servidores corporativos tradicionais experimentam utilização cíclica; o tráfego da web atinge o pico durante o horário comercial e diminui à noite, permitindo que os sistemas elétricos e de refrigeração operem com margens confortáveis. Em contraste, os modelos de treinamento de aprendizado profundo sincronizam dezenas de milhares de processadores para operar com utilização de 100% 24 horas por dia, 7 dias por semana.
Esse perfil de demanda implacável elimina a rede de segurança da “carga média”. Além disso, as características térmicas desses chips significam que, se os sistemas de refrigeração perderem energia — mesmo que momentaneamente — o silício atinge limites térmicos críticos em segundos, acionando desligamentos de emergência bruscos. Portanto, a resiliência elétrica está intrinsecamente ligada à sobrevivência térmica. Os engenheiros de instalações têm a tarefa de projetar sistemas que não apenas suportem cargas de base massivas, mas também gerenciem com eficiência falhas de hardware, anomalias na rede elétrica e manutenções programadas, sem jamais interromper a carga crítica.
Decifrando a Confiabilidade: A Filosofia do Tempo de Atividade
Na engenharia de instalações críticas, a disponibilidade é alcançada por meio da implantação estratégica de capacidade de reserva. Essa capacidade de reserva garante que, se um componente principal falhar — como um módulo de alimentação ininterrupta (UPS), um gerador de reserva ou um disjuntor de um painel de distribuição — um componente alternativo assuma a carga sem interrupções.
A indústria categoriza essas arquiteturas de confiabilidade usando uma nomenclatura matemática específica. A letra “N” representa a capacidade básica exata necessária para suportar a carga crítica de TI da instalação em plena utilização. Qualquer configuração além de “N” introduz resiliência. Os dois paradigmas mais proeminentes no projeto de instalações de missão crítica são a topologia compartilhada com um único equipamento sobressalente e a topologia independente totalmente espelhada.
Topologia de Reserva Única: N+1 Arquitetura
O N+1 A metodologia representa uma abordagem altamente eficiente para a manutenção simultânea. Nesta configuração, a instalação instala o número básico de componentes necessários (N) e adiciona exatamente um componente sobressalente adicional (+1) de capacidade igual.
Por exemplo, se a carga computacional de uma instalação exigir 4.000 kW de capacidade de UPS e a equipe de engenharia selecionar módulos de UPS de 1.000 kW, o requisito básico (N) será de quatro módulos. Nessa metodologia de reserva única, um quinto módulo de 1.000 kW é instalado. Durante a operação normal, a carga total de 4.000 kW é distribuída uniformemente entre os cinco módulos, o que significa que cada um opera com capacidade 80%.
Vantagens operacionais:
A principal vantagem dessa configuração com um único componente sobressalente é a eficiência de capital. Ela oferece uma robusta rede de segurança contra a falha de um único componente, sem exigir um investimento excessivo em hardware ocioso. Além disso, como a infraestrutura é compartilhada, ela normalmente opera com uma taxa de utilização mais alta, o que se traduz em uma melhor eficiência no uso de energia (PUE) e menores despesas operacionais (OpEx). Ela é ideal para ambientes onde janelas de manutenção curtas são toleradas ou onde as cargas de trabalho podem ser transferidas para diferentes zonas geográficas durante uma falha localizada.
Limitações inerentes:
A principal vulnerabilidade desse modelo de reserva compartilhada reside na sua distribuição a jusante. Embora haja um módulo UPS ou gerador de reserva, esses componentes normalmente alimentam um barramento de sincronização comum ou um único painel de distribuição primário. Se esse caminho compartilhado a jusante sofrer um curto-circuito catastrófico, um incêndio ou uma falha na placa lógica, toda a instalação fica sem energia, independentemente de quantos geradores de reserva a montante estejam funcionando perfeitamente. Ele protege contra falhas de componentes, mas não protege contra falhas no caminho de distribuição.
O paradigma da tolerância a falhas: 2N Arquitetura
Para organizações onde o tempo de inatividade é inequivocamente inaceitável, o setor depende de 2N framework. Essa arquitetura abandona o conceito de componentes sobressalentes compartilhados em favor da duplicação absoluta. Cada elemento da cadeia elétrica é multiplicado por dois, criando dois sistemas de energia completamente distintos, isolados e paralelos.
Se a carga crítica exigir 4.000 kW, a instalação constrói o “Sistema X”, capaz de fornecer 4.000 kW, e um “Sistema Y”, totalmente separado, também capaz de fornecer 4.000 kW. Em condições normais, ambos os sistemas operam simultaneamente, cada um suportando 50% da carga da instalação.
Tolerância absoluta a falhas:
Essa metodologia de duplicação completa elimina todos os pontos únicos de falha (SPOF). Ela parte do princípio de que qualquer equipamento, cabo ou lógica de controle eventualmente falhará. Ao manter duas infraestruturas fisicamente separadas — frequentemente alojadas em salas resistentes ao fogo completamente diferentes — os engenheiros garantem que uma falha explosiva ou um incêndio catastrófico no Sistema X não impactará fisicamente o Sistema Y. Quando o Sistema X falha, o Sistema Y absorve de forma contínua e instantânea os 50% restantes da carga, atingindo uma utilização de 100% sem interromper os processadores computacionais.
Conflitos econômicos e operacionais:
A segurança da tolerância absoluta a falhas exige um investimento financeiro considerável. Os gastos de capital (CapEx) são efetivamente duplicados, uma vez que a instalação precisa adquirir o dobro de geradores, sistemas UPS, quadros de distribuição e bombas de refrigeração. Operacionalmente, operar dois sistemas de grande porte com utilização de 50% introduz ineficiências. Transformadores e módulos UPS são inerentemente menos eficientes em cargas parciais, o que pode aumentar o desperdício de energia. Para mitigar esse problema, os operadores devem utilizar sistemas UPS modulares altamente avançados, equipados com modos de eficiência dinâmica.
Análise comparativa de topologias de confiabilidade
Para ilustrar claramente as distintas realidades operacionais e financeiras dessas duas filosofias de engenharia, a tabela a seguir resume seus principais atributos.
| Métrica de projeto | Um único sobressalente (N-Mais-Um) | Totalmente espelhado (Dois-N) |
|---|---|---|
| Definição básica | Capacidade mínima exigida mais uma unidade sobressalente compartilhada. | Duplicação total de toda a capacidade e vias de distribuição. |
| Tolerância a falhas | Sobrevive a uma única falha de equipamento (por exemplo, a falha de um sistema UPS). | Sobrevive a uma falha completa de sistema ou circuito (por exemplo, se uma sala elétrica inteira pegar fogo). |
| Caminhos de Distribuição | Caminho único e compartilhado até o servidor. | Dois caminhos completamente distintos e fisicamente separados. |
| Despesas de capital (CapEx) | Moderado. Excelente equilíbrio entre risco e investimento em termos de custo-benefício. | Extremamente alto. Requer provisionamento excessivo de infraestrutura (100%). |
| Eficiência Energética | Alta. Cargas compartilhadas permitem que os equipamentos operem próximos às curvas de eficiência máxima. | Menor. Os sistemas ficam ociosos com capacidade de 50%, resultando em pequenas perdas de energia parasitas. |
| Impacto da manutenção | A manutenção planejada de componentes é segura, mas a manutenção do percurso requer tempo de inatividade. | Qualquer componente ou circuito inteiro pode ser desenergizado com segurança, sem impacto algum na carga crítica. |
| Tempo de atividade típico padrão | Instituto de Tempo de Atividade Nível II / Nível III | Instituto de Tempo de Atividade Nível IV |
Resiliência em nível de rack: Implementando distribuição dupla
Gerar eletricidade contínua é apenas a primeira metade do desafio de engenharia; a segunda metade consiste em fornecer essa eletricidade com segurança aos processadores. Essa entrega final é realizada por meio de Caminhos de energia A/B.
Essa metodologia de roteamento garante que a redundância implementada na subestação da concessionária de energia e na central de geradores seja levada com sucesso até o chassi individual do servidor. Em uma verdadeira implementação de caminho duplo, o “Caminho A” se origina de um sistema UPS independente, enquanto o “Caminho B” se origina de um sistema UPS completamente separado.
A segregação física da distribuição
Para que esse roteamento de caminho duplo ofereça proteção real, a separação física é obrigatória. Os engenheiros instalam as vias aéreas do Caminho A ao longo do lado esquerdo do corredor de servidores, enquanto as vias do Caminho B são suspensas à direita. Essa segregação espacial garante que um incidente localizado — como o rompimento de um tubo de refrigeração, um arco elétrico localizado ou um erro humano de um técnico trabalhando em uma escada — não possa comprometer acidentalmente ambas as vias de segurança simultaneamente.
A partir dos barramentos aéreos, cabos blindados descem até duas Unidades de Distribuição de Energia (PDUs) montadas na parte traseira do gabinete do servidor. A conexão final depende do próprio equipamento de TI. Os chassis de computação de alto desempenho são fabricados com múltiplas fontes de alimentação com cabos duplos. Metade dessas fontes de alimentação é conectada exclusivamente à PDU do Caminho A e a outra metade à PDU do Caminho B.
Superando as vulnerabilidades de cabos únicos
Ocasionalmente, switches de rede ou controladores de gerenciamento especializados são fabricados com apenas um cabo de alimentação. Para integrar esses dispositivos em um ambiente de caminho duplo sem criar um ponto de falha localizado, os engenheiros implementam chaves de transferência automática (ATS) montadas em rack. A ATS se conecta tanto ao Caminho A quanto ao Caminho B. Se detectar uma queda de tensão em sua conexão primária, ela transfere mecanicamente o dispositivo com cabo único para a alimentação alternativa em uma fração de segundo — rápido o suficiente para que o processador nunca seja reiniciado.
A matemática do balanceamento de fases e do carregamento de racks
O gerenciamento de energia em nível de rack em ambientes de alta densidade exige engenharia elétrica meticulosa. Os operadores não podem simplesmente conectar dispositivos aleatoriamente; eles devem calcular o equilíbrio de fases em sistemas de distribuição trifásicos.
| Parâmetro elétrico | Rack padrão para empresas | Rack de computação de alto desempenho |
|---|---|---|
| Densidade típica de racks | 5 kW – 10 kW | 40 kW – 120+ kW |
| Requisitos de tensão | 120V / 208V | 240V / 415V (Trifásico) |
| Tipos de receptáculos | C13/C19 | IEC 309, Pino e Manga, Chicote Direto |
| Meio de resfriamento | Resfriamento de ar (corredor quente/frio) | Resfriamento líquido direto no chip e trocadores de calor da porta traseira |
| Comportamento de falha de trajetória | A rota A diminui; a rota B atinge instantaneamente a capacidade de 100%. | A rota A diminui; a rota B atinge instantaneamente a capacidade de 100%. |
Se o Caminho A falhar em um gabinete com alta carga, o Caminho B deverá suportar instantaneamente o dobro da sua corrente. Se os cabos, disjuntores ou PDUs no Caminho B não tiverem sido projetados com rigor e monitorados continuamente para garantir que sua utilização esteja em ou abaixo do limite de 50%, o influxo repentino de corrente durante um evento de failover acionará o disjuntor do Caminho B, resultando em uma interrupção total e localizada.
Tomada de Decisão Estratégica: Equilibrando Custo, Risco e Capacidade Ociosa
A seleção do modelo de infraestrutura apropriado é, em última análise, um exercício de gestão de riscos e modelagem financeira. Instalações que hospedam cargas de trabalho efêmeras, onde os dados são replicados em várias zonas geográficas e a latência é aceitável, geralmente optam por metodologias de reserva única. A economia de capital pode ser redirecionada para a compra de mais hardware de computação em vez de infraestrutura de concreto e cobre.
No entanto, para um campus soberano de treinamento algorítmico, o cálculo muda. Quando uma única instalação atua como um cérebro centralizado, processando grandes modelos de linguagem proprietários que representam bilhões de dólares em valor corporativo, o prêmio de capital de uma arquitetura de caminho duplo totalmente espelhada torna-se uma apólice de seguro obrigatória.
Um dos principais desafios que surgem nesses ambientes duplicados é a "capacidade ociosa". Como os sistemas espelhados são projetados para operar a 50% para absorver uma falha completa, enormes quantidades de capacidade elétrica paga ficam ociosas. Operadores de instalações com visão de futuro estão empregando orquestração de energia sofisticada definida por software. Essas camadas de monitoramento permitem que os operadores utilizem com segurança parte dessa capacidade ociosa para trabalhos em lote de baixa prioridade e preemptíveis. Se um caminho de energia falhar, o software interrompe instantaneamente as cargas de trabalho de baixa prioridade em milissegundos, garantindo que haja sobrecarga suficiente no caminho elétrico restante para sustentar as cargas de trabalho críticas.
Conclusão
À medida que a escala computacional do Centro de Dados de IA À medida que a demanda continua a crescer, a infraestrutura elétrica subjacente precisa evoluir de sistemas estáticos para ecossistemas dinâmicos, inteligentes e extremamente resilientes. Projetar essas instalações não se resume mais à aquisição de transformadores gigantescos; trata-se de orquestrar topologias complexas capazes de absorver falhas caóticas sem interrupções. Ao aderir rigorosamente a modelos de redundância meticulosamente calculados e impor uma separação física intransigente entre a rede elétrica e o servidor, os engenheiros podem garantir o fluxo contínuo e ininterrupto de energia necessário para impulsionar a próxima geração da inovação humana.
Perguntas frequentes
1. Como as operadoras justificam o enorme acréscimo de despesas de capital (CapEx) necessário para sistemas de energia totalmente duplicados em um Data Center de IA?
A justificativa financeira baseia-se no custo do tempo de inatividade em comparação com o custo da infraestrutura. Em operações de aprendizado de máquina, uma queda de energia pode corromper um ponto de verificação do treinamento de um modelo, o que significa que semanas de trabalho computacional precisam ser descartadas e reiniciadas. A perda financeira de uma única interrupção significativa (calculada em tempo perdido pelos desenvolvedores, lançamentos de produtos atrasados e energia desperdiçada) geralmente excede em muito o custo inicial de construção de uma topologia elétrica totalmente espelhada.
2. Por que um gerador de reserva não é suficiente para evitar interrupções sem a necessidade de caminhos de energia A/B independentes?
Um gerador de reserva protege apenas contra falhas originadas na rede elétrica externa. No entanto, dados operacionais históricos comprovam que a maioria das interrupções em instalações é causada por falhas em componentes internos, como um curto-circuito localizado no quadro de distribuição, um disjuntor desarmado ou erro humano durante a manutenção. Caminhos duplos e independentes garantem que uma falha interna entre o gerador e o andar dos servidores não resulte na interrupção de cargas críticas.
3. Se uma instalação utiliza uma metodologia de reserva única (N+1), ela ainda pode suportar racks de alta densidade com refrigeração líquida de 100 kW?
Sim, a densidade de potência do rack e os níveis de redundância da instalação são conceitos independentes. Uma instalação com um único componente de reserva pode, sem dúvida, fornecer 100 kW a um rack usando barramentos de alta amperagem e refrigeração líquida direta no chip. No entanto, o operador deve aceitar que, se uma placa elétrica compartilhada a jusante precisar de manutenção ou apresentar uma falha, esse rack de 100 kW ficará offline. Alta densidade é uma questão de dimensionamento da capacidade, enquanto redundância é uma questão de engenharia de caminhos de energia.

